AI 把幻灯片做漂亮了,最后一公里是能改
前几年的“AI 做 PPT”,多半只是帮你更快地排一个标题、几条要点,再配一张图库图片。能用,但一看就是套模板。图像生成模型改变了这件事:复杂的系统架构图、漫画式讲解、产品发布页、课程插图,还有各种不按常理出牌的信息排版,现在都能在一张画布里一次画出来。
只看效果,幻灯片设计好像已经被 AI 解决了。麻烦在后头:画得最好看的方案,交到你手里往往只是一张图片。汇报前想把日期改成明天、把 12% 换成 15%、把领导的名字改对,都做不到——标题是像素,图表标签是像素,卡片也挪不动。页面是设计好了,PowerPoint 里的活还一点没开始。
我们的判断是:更顺手的 AI 做 PPT 方式,正在变成“先生成图片,再还原成可编辑 PowerPoint”。好看交给图像模型,能改交给重建:把图片还原成一个个可以修改、可以交出去的对象。
行业里生成幻灯片的三条路线
目前常见的 AI 幻灯片产品,大体走三条路线。它们都能解决一部分问题,但优化目标并不相同。
| 方式 | 擅长什么 | 根本限制 |
|---|---|---|
| 直接生成 PPTX | 文件从一开始就是原生对象,天然可编辑。 | 模型必须把视觉意图翻译成坐标、形状、字体和大量排版指令。复杂插画、密集构图和自由视觉语言很难用标准 PowerPoint 图形稳定表达。 |
| 基于 HTML 生成 | 结构稳定、生成速度快,适合规则化和重复性页面。 | 容易收敛到卡片、分栏和文本块。复杂示意图、漫画、自由排版和特殊视觉构图不容易表达,导出到 PowerPoint 时也可能损失布局。 |
| 直接生成幻灯片图片 | 视觉自由度最高。字体、插画、地图、图表、质感和氛围可以在一张画布里统一完成。 | 输出通常是一张扁平位图,看起来像幻灯片,却不能像幻灯片一样编辑。 |
当可编辑性和规则结构比视觉表达更重要时,直接生成 PPTX 是正确选择;当页面主要是规则化内容时,HTML 也非常高效。但如果需求是一张内容密集的解释图、一页漫画式叙事,或者一种根本不适合套模板的视觉语言,图片生成拥有明显优势:它不受 PowerPoint 形状词汇和浏览器排版系统的限制。
缺失的另一半:把图片重建成对象
既然图片负责好看,下一步自然是把“能改”找回来。最常见的做法是文字识别:认出图里的字,再在图片上盖一层文本框。这样能打字了,但图片并没有因此变回一页真正的幻灯片。
一张真实的 PPT 是有层次的文档。文字属于卡片或图表,形状有填充、边框和叠放顺序,箭头连接不同区域。把原图里的文字拿走后,后面的颜色、纹理和边框还必须补回来。最后还要面对 PowerPoint 自己的字体度量、换行、最小尺寸和渲染规则。
因此,真正可用的重建必须同时解决:
- 对象理解:分清文字、容器、连接线、图表、插画、图标和纯装饰。
- 几何精度:恢复实用的对象边界与叠放顺序,避免文字和视觉内容相互漂移。
- 背景修复:去掉原图中已经烤死的文字和素材,同时避免白块、重影和残留。
- 渲染控制:在视觉还原、可编辑程度和计算成本之间取得平衡,并适应 PowerPoint 的真实排版方式。
所以光是“字能改”远远不够。盖一层文字框,截图看着挺像样;可你把标题框往旁边一拖,底下的旧字还在原处,卡片也不是真卡片,整页的结构仍然锁在一张背景图里。
Image2PPT 重建什么,又刻意保留什么
Image2PPT 不是让一个模型一次性重画整页,而是通过多阶段系统完成结构理解、文字与规整几何重建、复杂视觉元素拆分、背景修复和原生 PPTX 渲染。
产品上最重要的取舍,是不强迫每一个像素都变成矢量图形。文字和简单结构应该可编辑,因为用户经常要修改它们;地图、复杂图表、插画和图标如果重画会明显变差,就应该原样保留为独立图片。它们内部的像素不能逐点修改,但可以单独移动、裁剪、替换、缩放或删除。
这样拿回来的,不是一张锁死的截图,而是一组真正用得上的对象:常改的字和结构都能直接改,复杂画面高保真还原,不会被重画得走样。
用一张故意做难的图验证
为了验证这套思路,我们生成了一张内容密集的城市水务数字孪生幻灯片。它同时包含中央城市插画、地图、曲线图、公式、卡片、图标、图例和长距离连接线。这接近重建任务的困难输入,而不是一张专门挑出来展示成功率的标题页。
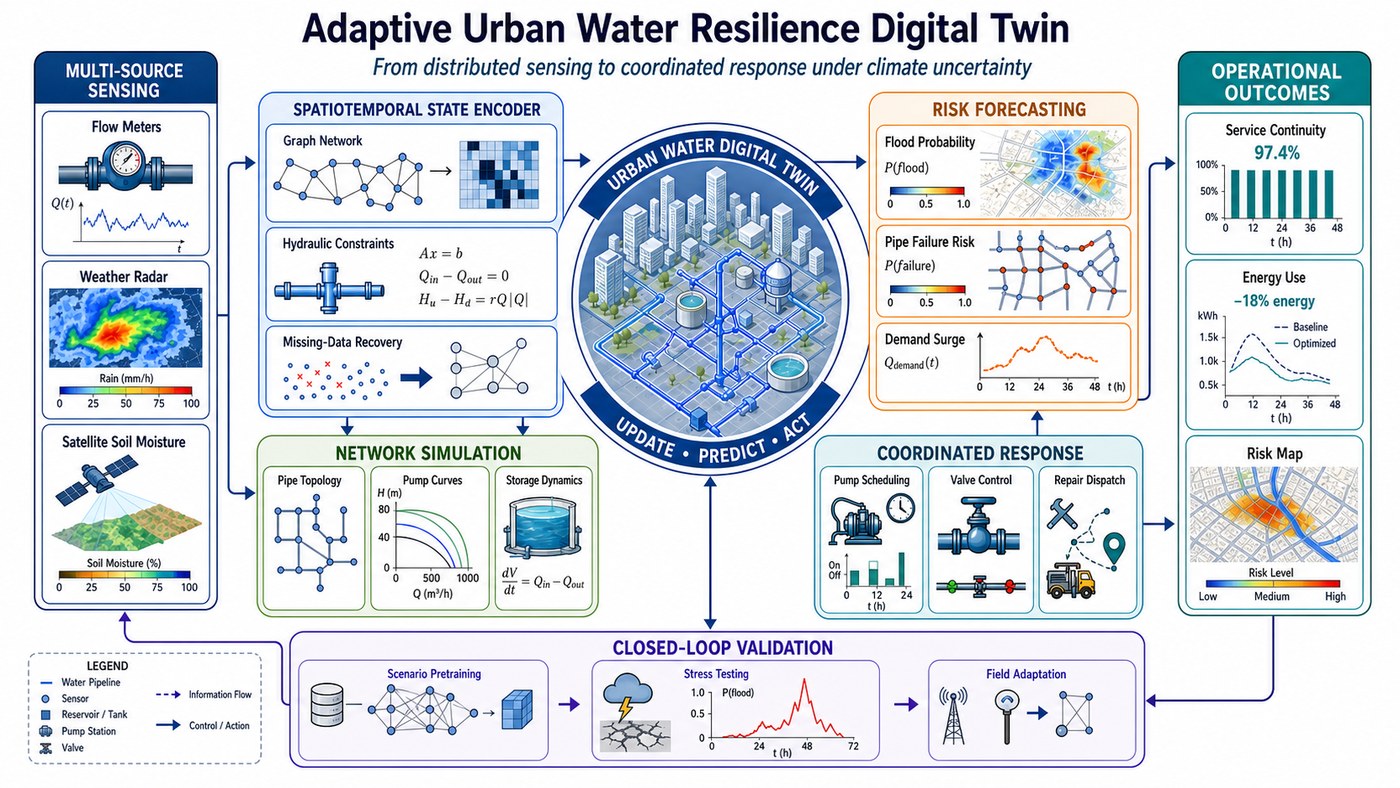
转换完成后,我们用 Microsoft PowerPoint 打开文件并执行“全选”。下面这张图故意显得很乱:每一个选框都在证明那里是一个独立的 PowerPoint 对象。
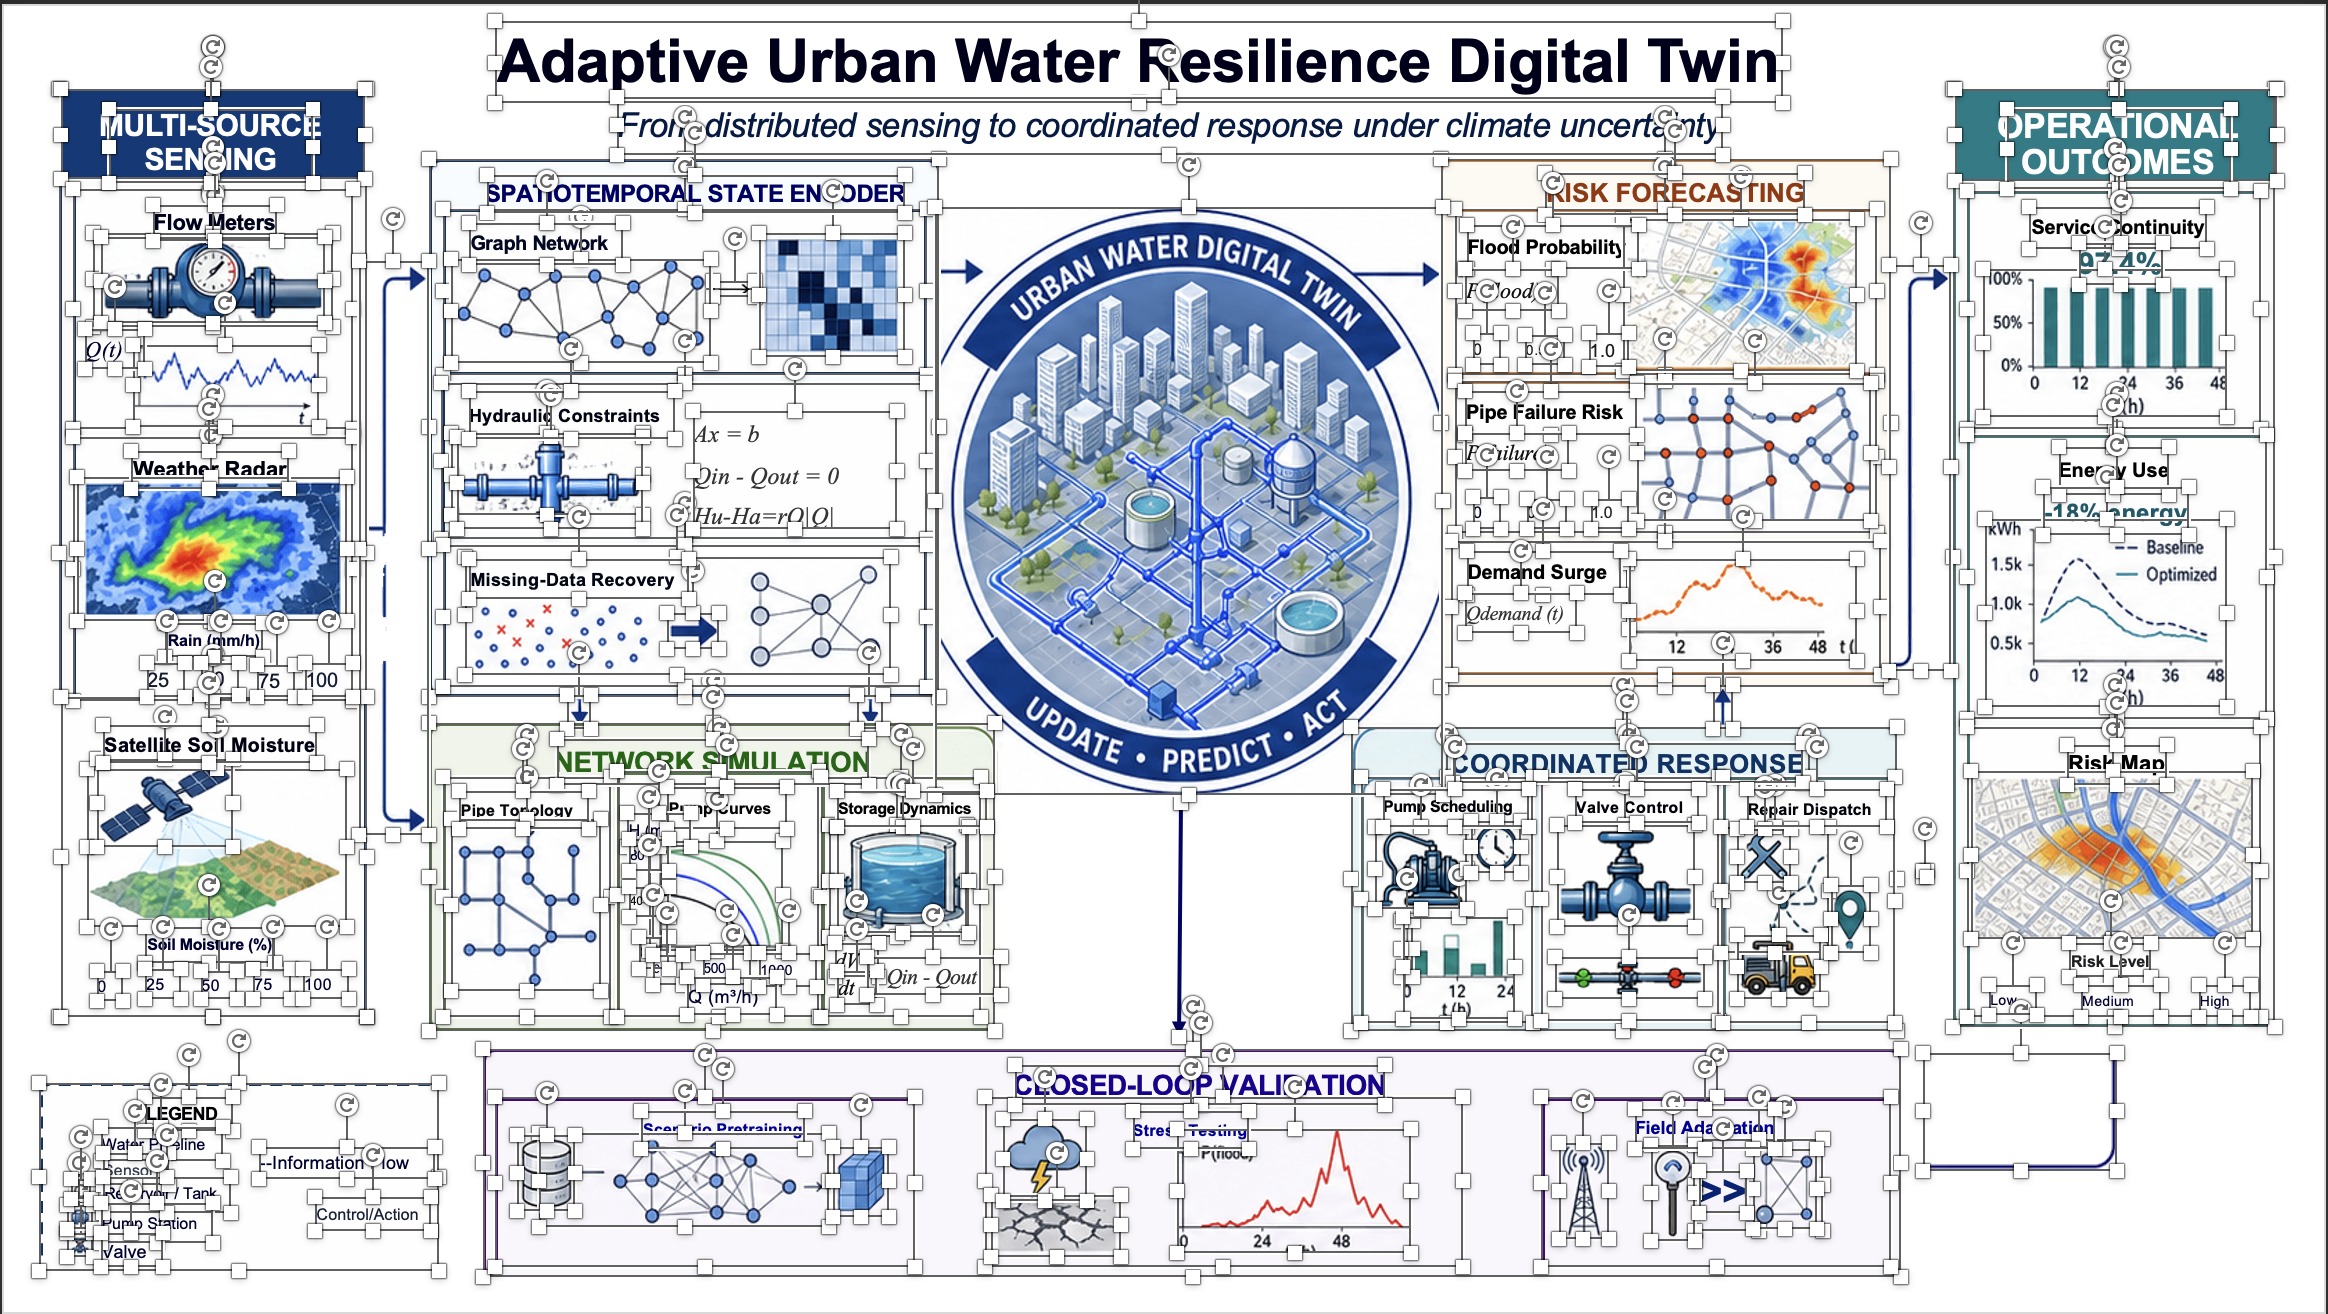
78 个文字框可以直接重新输入;33 个形状可以移动、缩放和修改样式;54 个图片对象负责保留地图、图表、示意图和插画等复杂视觉区域,可以独立移动、裁剪、替换或删除。
这页已经不再是一张只能看的图片,而是一份可以接着改、拿去审、最后交出去的工作文件。
这会怎样改变 AI 做 PPT 的工作流
过去大家默认,一个 AI 幻灯片系统必须直接输出 PowerPoint。这个要求把视觉创作和文档结构挤在同一个生成步骤里。两阶段流程可以把它们分开:
- 先用图像模型探索视觉方向,生成效果最好的幻灯片图片。
- 再通过重建恢复文字、布局和独立视觉对象。
- 最后回到 PowerPoint 改文案、换数字、挪位置、换成公司的字体、加上 Logo,然后交付。
这并不意味着直接生成 PPTX 或 HTML 会消失。规则化汇报、固定模板和数据驱动页面仍然更适合这些方式。我们想表达的判断更具体:图片生成消除了视觉上限,而对象级重建消除了“只能看、不能改”的代价。两者组合之后,才能完成任何单一路线都很难独立完成的幻灯片。
最后一公里本身就是产品
生成一张漂亮图片很惊艳,但真正有用的是:汇报前一晚领导说标题换个说法、数据更新到上个月,你打开文件几分钟就改完,不用把整页重做一遍。好看的图和能改的文件之间这段距离,就是剩下要解决的问题。
Image2PPT 要做的,就是把这后半段做扎实:你要改的文字和结构,还原成能直接改的对象;不适合重画的复杂画面,高保真地原样保留。幻灯片长什么样,AI 也许已经解决了;接下来要做的,是把这页幻灯片真正交回到你手里。
把 AI 生成的幻灯片图片变成可编辑 PPT
先挑一页最难的传上来,AI 生成的图、截图或导出的 PDF 都行。在 PowerPoint 里打开、全选,再试着改个标题、换个数字,看看能省下多少重做的工夫。